
ИИ-шлюз (AI Gateway) – облачный сервис, цель которого в том, чтобы предоставить единую точку доступа к генеративным моделям разных разработчиков. В рамках этого сервиса модели OpenAI, Anthropic, Google, DeepSeek, Qwen и других доступны через один ключ и один формат запросов, с оплатой в рублях с баланса аккаунта Beget. Отдельная регистрация у каждого вендора и зарубежная карта не требуются.
Адрес шлюза: https://api-llm.beget.com/v1
Назначение сервиса
Обратиться к нейросети можно двумя способами. Через чат в браузере – так работают привычные чат-боты, и для личных задач этого достаточно. Либо программно: ваш сайт, бот или скрипт отправляет запрос по сети, получает ответ и использует его дальше – сохраняет в базу, показывает пользователю, запускает следующее действие. Второй способ называется работой через единый API.
ИИ-шлюз предоставляет доступ по API. Он предназначен для случаев, когда модель должна работать внутри вашего продукта: пользователь видит подсказку, автоматический ответ или готовое описание товара, не зная, что его сформировала нейросеть.
Из этого следует основное требование к пользователю услуги: код, отправляющий запросы, вы пишете сами, поэтому нужен хотя бы базовый опыт программирования. Готовых решений вида «включить ИИ на сайте» услуга не содержит.
Принцип работы
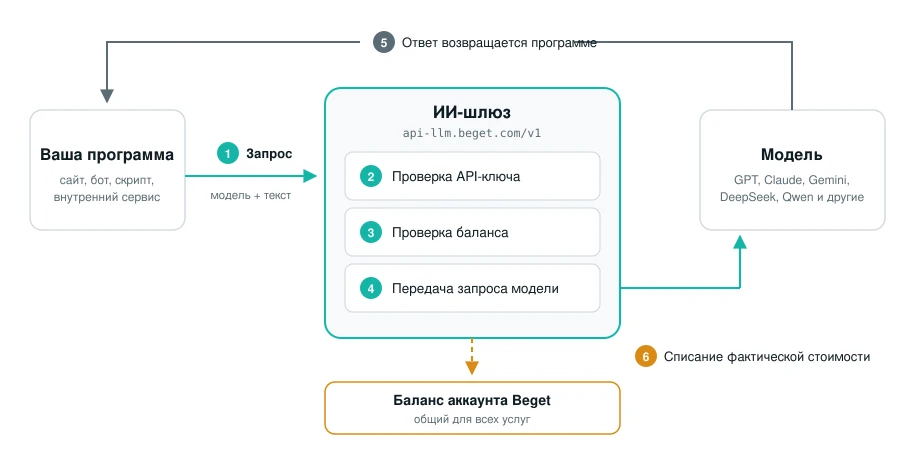
Программа отправляет на адрес шлюза запрос с указанием модели и текста обращения. AI-шлюз проверяет ключ и достаточность средств на балансе, передает запрос выбранной модели, возвращает ответ и списывает стоимость запроса.
Формат запроса одинаков для всех моделей каталога. Чтобы заменить одну модель другой и подключить новую LLM, достаточно изменить ее название в коде – переписывать интеграцию и изучать новую документацию не требуется.
Шлюз совместим с API OpenAI. Существующая интеграция с OpenAI переводится на шлюз изменением трех параметров: адреса, ключа и названия модели. Библиотеки, обработка ответов и обработка ошибок остаются прежними.
Модели
Список доступных для подключения через один API моделей нейросетей и их актуальные цены находятся в каталоге в панели управления, а также доступны через запрос GET /v1/models. Данные каталога могут изменяться: добавляются новые модели, недоступные модели удаляются, цены могут обновляться. В связи с этим не следует указывать список моделей и цены в коде – получайте актуальные данные из каталога в панели управления или запросом к шлюзу.
Выбор модели
Внедрение LLM стоит начинать с недорогой модели – и переходить к более мощной только при недостаточном качестве. Разница в цене между легкой и флагманской моделью достигает десятков раз, тогда как на простых задачах – классификация, извлечение полей – разница в качестве незначительна. Использование флагманской модели для простых задач остается основной причиной завышенных расходов.
Сравнивайте не цену модели, а стоимость запроса: более дорогая модель, отвечающая короче и точнее, в итоге обходится не дороже дешевой, ответы которой приходится уточнять повторными запросами.
Тип модели стоит выбирать в зависимости от задачи:
- классификация, теги, короткие ответы, извлечение полей – легкие быстрые модели;
- диалоговый ассистент, генерация и редактирование текстов – универсальные модели среднего уровня;
- анализ договоров, сложные рассуждения, многошаговые задачи – флагманские модели и модели с рассуждением;
- написание и разбор кода – модели с кодинг-специализацией;
- большие документы и длинная переписка – модели с большим контекстным окном;
- поиск по смыслу – модели эмбеддингов.
Эмбеддинги и поиск по смыслу
Эмбеддинг – представление текста в виде набора чисел, отражающего его смысл. Тексты с близким смыслом получают близкие наборы чисел независимо от того, какими словами они написаны. За счет этого запрос «не приходит письмо» возвращает статью «проблемы с доставкой почты».
Порядок применения:
- Все статьи, товары или документы один раз обрабатываются моделью эмбеддингов, результат сохраняется в базу.
- Вопрос пользователя обрабатывается той же моделью.
- В базе находятся записи с наиболее близкими значениями.
- Найденные фрагменты передаются чат-модели вместе с вопросом.
Модель отвечает, опираясь на переданные материалы, а не на общие сведения. Такой подход называется RAG и является стандартным способом получить ответы по собственной базе знаний.
Два условия. Хранилище векторов разворачивается на вашей стороне – подойдет расширение pgvector для PostgreSQL или отдельная база вроде Qdrant. Вся коллекция должна быть обработана одной моделью эмбеддингов: значения, полученные от разных моделей, несравнимы между собой, при смене модели индекс пересобирается целиком.
Тарификация
Оплата производится по факту использования, без абонентской платы и пакетов. Бесплатного тарифа и пробного периода нет. Средства списываются с общего баланса аккаунта Beget, отдельного счета у услуги нет.
Токены
Модель работает не со словами, а с токенами: часть слова, короткое слово или знак препинания. Ориентировочное соответствие – 1000 токенов на 750 слов (числа примерные, точные числа зависят от модели и используемого в ней токенизатора). При обработке русского текста расходуется больше токенов, чем английского того же объёма по смыслу.
Тарифицируются обе стороны обмена:
- входящие токены – инструкция модели, вопрос пользователя, приложенный текст, история переписки;
- исходящие токены – ответ модели.
Расчет стоимости
стоимость = (входящие_токены / 1 000 000) × цена_входящих + (исходящие_токены / 1 000 000) × цена_исходящих
Пример для модели gpt-5.5 (440 ₽ входящие / 2 638 ₽ исходящие за 1M): запрос на 500 входящих и 200 исходящих токенов ≈ 0,7476 ₽.
Цены приведены для примера и могут отличаться от актуальных.
Считать вручную не требуется: в каждом ответе шлюз возвращает блок usage с количеством токенов, потраченных на запрос и на ответ. По этим данным расход учитывается на стороне вашего приложения.
При построении диалога учитывайте, что история отправляется заново с каждым запросом. Модель не хранит предыдущие реплики – чтобы она понимала контекст, переписка передается целиком при каждом обращении. Двадцатая реплика чата содержит девятнадцать предыдущих и тарифицируется соответственно. Обычно в длинных диалогах старые сообщения обрезают или заменяют кратким пересказом.
Проверка баланса перед запросом
Средства не резервируются. Перед отправкой шлюз рассчитывает максимально возможную стоимость запроса и сравнивает ее с балансом. Если расчетная сумма превышает остаток, запрос отклоняется.
Расчет зависит от того, ограничена ли длина ответа параметром max_tokens:
- ограничение задано – расчет ведется по нему;
- ограничение не задано – расчет ведется исходя из того, что модель израсходует все оставшееся контекстное окно.
У моделей с окном в сотни тысяч и миллионы токенов расчетная сумма во втором случае достигает сотен рублей, из-за чего отклоняется даже короткий запрос, фактическая стоимость которого составила бы копейки.
Указывайте max_tokens во всех запросах. Это устраняет ложные отказы и ограничивает длину ответа. Списывается после обработки фактический расход, а не расчетная сумма.
Что не тарифицируется
Ошибки, возникшие до обращения к модели, бесплатны: неверный ключ, недостаток средств, запрещенная для ключа модель, превышение частоты запросов. Если модель начала формировать ответ, использованные токены оплачиваются, в том числе при обрыве соединения.
Снижение расходов
- Ограничивайте длину ответа параметром max_tokens.
- Подбирайте модель под задачу, не используя флагманские модели для простых операций.
- Сокращайте инструкцию модели: она передается с каждым запросом.
- Обрезайте историю диалога или заменяйте ее пересказом.
- Разделяйте обработку: недорогая модель отбирает и классифицирует, дорогая обрабатывает только то, что требует высокого качества.
- Используйте кеширование промпта: повторяющееся начало запроса (системная инструкция, большой контекст) можно кешировать и платить за него меньше – выгодно при многократном переиспользовании одного и того же префикса.
Фактический расход отображается в статистике услуги в разрезе моделей, ключей и дней, с фильтрами и выгрузкой в CSV.
Начало работы
1. Пополните баланс
Средства списываются с общего баланса аккаунта. При нулевом балансе запросы отклоняются.
2. Создайте API-ключ
Ключ API LLM-моделей создается в разделе ИИ-шлюза в панели управления, там же задаются его ограничения.
Секретное значение ключа отображается один раз, при создании. Сохраните его сразу: восстановление невозможно, при утрате выпускается новый ключ.
3. Отправьте запрос
Пример на Python с официальной библиотекой openai:
from openai import OpenAI
client = OpenAI(
    base_url="https://api-llm.beget.com/v1",
    api_key="ваш ключ",
)
response = client.chat.completions.create(
    model="название модели из каталога",
    messages=[
        {"role": "system", "content": "Ты – вежливый ассистент службы поддержки."},
        {"role": "user", "content": "Как восстановить пароль?"},
    ],
    max_tokens=512,
)
print(response.choices[0].message.content)
Назначение параметров:
base_url– адрес шлюза. Именно он отличает обращение к Beget от обращения напрямую к OpenAI;model– название модели из каталога;- сообщение с ролью
system– инструкция, задающая модели роль и правила поведения; - сообщение с ролью
user– запрос пользователя; max_tokens– ограничение длины ответа.
Официальные библиотеки OpenAI доступны также для JavaScript. На других языках запрос отправляется обычным HTTP-запросом с заголовком Authorization: Bearer ваш_ключ.
4. Проверьте результат
Текст ответа возвращается в поле choices[0].message.content, количество израсходованных токенов – в блоке usage. Значение length в поле finish_reason означает, что ответ обрезан по заданному ограничению длины и модель не завершила его самостоятельно.
API-ключи и контроль расходов
Использовать один ключ для всех задач с LLM-моделями не рекомендуется. В этом случае расход не разделяется по сервисам, а при компрометации ключа API доступ к LLM приходится отзывать сразу у всех интеграций.
Настройки ключа изменяются в любой момент.
Месячный лимит в рублях. Ограничивает расход по ключу за календарный месяц. Лимит включается и отключается отдельным переключателем. При включении лимит можно установить до 100 000 000 рублей в месяц. При его исчерпании запросы по этому ключу отклоняются до первого числа следующего месяца, остальные ключи продолжают работать. Лимит не резервирует средства, а ограничивает долю баланса, доступную одному ключу.
Список разрешенных моделей. Пустой список означает доступ ко всем моделям каталога. Если список задан, обращение к модели вне списка отклоняется. Применяется, чтобы тестовый ключ не мог обратиться к дорогой модели.
Статус. Отключенный ключ немедленно перестает работать, оставаясь в списке вместе со статистикой. Используется для быстрой остановки интеграции без удаления ключа.
Всего в аккаунте создается до 25 ключей.
Безопасность ключа
Ключ позволяет расходовать средства с вашего баланса, поэтому обращаться с ним следует как с паролем.
Храните ключ в переменных окружения или в менеджере секретов, а не в коде. Добавьте файл .env в .gitignore до первого коммита: ключ, попавший в публичный репозиторий, считается скомпрометированным независимо от последующего удаления коммита, поскольку остается в истории и в кешах.
Ключ нельзя использовать во фронтенде. Код, выполняющийся в браузере или в мобильном приложении, доступен пользователю вместе с ключом. Запросы к моделям должны отправляться с вашего сервера.
Не передавайте ключ в переписке, тикетах и на скриншотах. Сотрудникам поддержки Beget он не требуется.
При компрометации ключа: отключите его, выпустите новый и обновите в сервисах, удалите старый. Незнакомые модели и всплеск расхода укажут на стороннее использование. Заданный месячный лимит в этой ситуации ограничивает возможный ущерб.
Лимиты и ограничения
Для аккаунта установлены следующие лимиты:
- ключей на аккаунт – до 25;
- месячный лимит ключа – настраивается в рублях, максимальный лимит – 100 000 000 рублей в месяц;
- баланс аккаунта – общий на все ключи и услуги.
Баланс аккаунта и месячный лимит ключа действуют независимо, ограничение срабатывает по любому из них. Месячный лимит обнуляется в начале календарного месяца.
Данные и конфиденциальность
Шлюз не запускает модели на своей стороне, а передает запросы их разработчикам. Обработка переданного текста регулируется правилами этих компаний и не находится под контролем Beget.
Не передавайте в запросах персональные данные, платежную информацию, учетные данные и коммерческую тайну.
Для задач, где такие данные участвуют, применяется обезличивание. Перед отправкой приложение заменяет реальные значения на заглушки: ФИО – на [КЛИЕНТ_1], номер договора – на [ДОГОВОР], телефон – на [ТЕЛЕФОН]. Модель обрабатывает обезличенный текст, а в полученный ответ приложение подставляет исходные значения. Качество результата при этом практически не снижается.
На стороне Beget сохраняются только сведения о факте запроса: время, модель, ключ, количество токенов, стоимость, результат обработки. Тексты запросов и ответов не записываются.
Если содержимое переписки требуется для разбора инцидентов, сохраняйте его на своей стороне: по статистике услуги восстановить его невозможно.
Частые вопросы
Один ключ ко всем моделям вместо отдельного аккаунта у каждого вендора, оплата в рублях с баланса Beget вместо зарубежной карты, общая статистика и лимиты в одном месте, возможность сменить модель без переработки интеграции.
Нет, шлюз доступен из любой инфраструктуры, требуется только ключ.
Для работы через API – да, на базовом уровне.
Адрес, ключ и название модели. Остальной код остается прежним. Перед переключением прогоните типовые запросы и убедитесь, что выбранная модель отвечает ожидаемым образом.
При работе через API запросы оплачиваются по общим тарифам: стоимость фактически обработанных токенов списывается с баланса аккаунта.
С общего баланса аккаунта Beget.
В запросе не ограничена длина ответа, и стоимость рассчитана по максимуму, либо максимально возможная стоимость запроса превышает текущий баланс. Укажите max_tokens.
Ошибки, возникшие до обращения к модели, не тарифицируются. Если модель начала формировать ответ, использованные токены оплачиваются.
В каталоге в панели управления или запросом GET /v1/models. В код список и цены записывать не следует.
На стороне Beget – нет, сохраняются только сведения о факте запроса. Обработка текста на стороне разработчиков моделей регулируется их правилами.
Нет, данные необходимо обезличивать перед отправкой.
Отключить его, выпустить новый, обновить в сервисах, удалить старый и проверить статистику за последние дни.
После создания ключа в списке отображается только его маска, например, sk1-*******asda. Полное значение ключа восстановить не получится. Если ключ утрачен, выпустите новый.
Если возникнут вопросы, напишите нам, пожалуйста, тикет из панели управления аккаунта (раздел “Помощь и поддержка”), а если вы захотите обсудить, как использовать API AI, или просто пообщаться с коллегами по цеху и сотрудниками Beget – ждем вас в нашем сообществе в Telegram.


